在图纸与场地之间:我的设计作品集
从游园到公共空间,从植物层次到小尺度建筑。四组设计练习,记录我在图纸与场地之间的学习。
yueduqi-desktop 是一个用 Go + Wails v2 构建的桌面阅读器。后端解析多个书源的网页/API 返回搜索结果和章节内容,前端用 React + TypeScript 渲染界面。
优化前的状态:能跑,但有很多”差不多就行”的妥协——
/tmp,无级别控制_ 吞错的写法cache/cache.go用 Go 泛型实现了一个带 TTL 的内存缓存:
1 | type Cache[T any] struct { |
热榜(5min TTL)、搜索(3min TTL)、章节列表(10min TTL)各自独立实例。支持运行时开关、统计命中率。
storage/storage.go用 modernc.org/sqlite(纯 Go,无 CGO)实现了完整的本地数据库:
bookshelf 表:书架数据,INSERT OR IGNORE 去重reading_progress 表:阅读进度,ON CONFLICT DO UPDATE upsertsettings 表:用户偏好键值存储memStore 兜底:SQLite 不可用时自动切换内存模式Wails 绑定的 Go 方法(AddToBookshelf、GetBookshelf、UpdateProgress 等)从前端 api.ts 直接调用,不再走 HTTP 层。
config/config.go用 gopkg.in/yaml.v3 加载 ~/.config/yueduqi/config.yaml:
1 | hosts: |
文件不存在时用 Default() 返回合理默认值,不报错。
log.Logger 到 log/slog1 | // 之前 |
结构化日志,支持 debug/info/warn/error 级别,路径从配置读取。
Registry 模式取代 switch-case:
1 | // parser.go |
类型安全: mapItem(map[string]any)替换为具体 struct:
1 | type searchBookItem struct { |
HTTP 连接池:
1 | var httpClient = &http.Client{ |
错误处理修复: 所有 req, _ := http.NewRequestWithContext(...) 改为显式处理 error。
广告过滤合并正则: 18 个独立 regexp.MatchString 合并为单个 adRe,从 O(n×m) 降到 O(n)。
api.ts 中书架和进度相关的 stub 全部替换为真实调用:
1 | // 之前 |
一开始用 Claude Code 的 Workflow(多 agent 编排)做优化,但 Workflow 里 agent 的文件搜索先命中了 yueduqi-desktop(字母序靠前),而我真正想优化的是 yueduqi-go。整轮 18 个 agent、66 万 token 全打在了 desktop 上。
解决: 发现后确认 desktop 本身也确实需要优化,就顺势做下去了。教训是给 Workflow 指定目标时要明确绝对路径。
对于 6 个 Go 文件的小项目,Workflow 的 18 个 agent 每个都要加载完整的系统提示和工具定义(~7K tokens/个),还要各自读一遍代码。66 万 token 里大半是重复的上下文传输。如果是自己直接在主线改,2-3 万 token 就够。
解决: 认识到 Workflow 适合 50+ 文件的大规模审查、跨仓库迁移等场景。小项目应该直接动手改。
Workflow 跑完后我一看 token 消耗,觉得太浪费,冲动之下把所有改动回滚、分支删除。冷静下来才意识到——代码本身是好的,编译通过,质量不错。浪费的是 token,不是代码。
解决: 用 git reflog 找回 commit,用 git stash pop 恢复未提交改动,手动重建了被 rm 掉的 config/ 和 storage/ 目录。
Workflow 自动生成的代码里,httpClient.Timeout = 15s 是全局上限,但 contentTimeout = 20s 想给内容请求更宽裕的时间。结果 20s 永远用不到——还没到就被 client 层 15s 截胡了。
解决: 把 contentTimeout 降到 15s,和全局超时保持一致。各操作实际生效超时:搜索 8s,章节列表 15s(全局兜底),内容获取 15s。
1 | 17 files changed, 853 insertions(+), 48 deletions(-) |
| 模块 | 文件 | 说明 |
|---|---|---|
| 缓存 | cache/cache.go |
泛型 TTL 内存缓存,统计命中率 |
| 配置 | config/config.go |
YAML 加载,默认值优雅降级 |
| 存储 | storage/storage.go |
SQLite + 内存双后端,书架/进度/设置 CRUD |
| 解析 | parser/*.go |
Registry 模式、类型安全、连接池、错误处理 |
| 应用 | app.go |
slog 结构化日志、Store 接口 |
| 入口 | main.go |
XDG 数据目录、SQLite 初始化 |
| 前端 | api.ts 等 |
书架/进度真实 API 调用 |
Workflow 要对项目规模有判断。 不是什么任务都值得上多 agent 编排。文件数 < 20 的项目,直接改更快更省。
删代码前先看一眼。 不要被 token 数字吓到——消耗已经发生了,成果是实在的。删掉再恢复只会浪费更多。
超时配置要全局一致。 多层超时(context + client)容易互相截胡。要么都走 context,要么都走 client,别混用。
纯 Go SQLite 真香。 modernc.org/sqlite 不需要 CGO,编译出来的二进制照样是单文件。桌面应用持久化的最佳选择。
先跑通,再优化。 这次改动的 17 个文件全部编译通过、Wails dev 模式正常运行。没有引入回归是最大的胜利。
项目的完整代码在 GitHub 上。
Linux 桌面没有「设置 → 字体」一键搞定。字体的配置分布在四个独立的层面,各管各的:
1 | ┌──────────────────────────────────────┐ |
理解这四层,就不会问「为什么改了 fontconfig 我的终端字体没变」——因为终端在第 1 层就写死了。
fontconfig 是 Linux 字体系统的核心引擎。它不是应用,是一个库——所有 GTK/Qt/浏览器在需要渲染文字时都调用它。
配置文件放在 ~/.config/fontconfig/fonts.conf,XML 格式。主要能干四件事:
当程序说「我要 sans-serif」时,fontconfig 告诉你应该给哪个字体:
1 | <alias> |
Linux 装了多个 CJK 字体时,经常把中文的「门」「复」「直」显示成日文的字形。按语言精确分配:
1 | <match target="pattern"> |
浏览网页或打开 Windows 文档时,把网页请求的 微软雅黑、Arial、SimSun 全部拦截,换成自己系统里的高清字体:
1 | <match target="pattern"> |
这样打开任何中文网站,眼不见为净——再也没有中易宋体的锯齿和微软雅黑的过时骨骼。
1 | <match target="font"> |
hintslight — 轻度微调,适合高分屏rgba=rgb — 标准 LCD 次像素排布embeddedbitmap=false — 禁用点阵字,消灭旧宋体的锯齿毛边改完配置后必须刷新缓存:
1 | fc-cache -fv |
然后用 fc-match 验证每一项:
1 | # 默认字体族 |
命令行验证通过,重启应用就能看到效果。
经过多轮对比和实战,这里给出一套适合中文用户的字体组合:
| 用途 | 字体 | 特点 |
|---|---|---|
| 无衬线 UI | MiSans | 小米开源,字形现代化,屏幕阅读舒适 |
| 衬线阅读 | LXGW WenKai / 霞鹜文楷 | 霞鹜基于 Klee One 制作,温润有书写感 |
| 等宽 / 终端 | Maple Mono NF CN | 圆角等宽,带 Nerd Font 图标,中文支持好 |
1 | paru -S otf-misans ttf-lxgw-wenkai-screen maple-mono-nf-cn |
完整配置文件我放在了 GitHub: emoeem/fontconfig,核心思路和上面一致——别名 → 语言映射 → 商业字体劫持 → 渲染设置。
先用 fc-cache -fv 刷新缓存,再 fc-match 验证,最后重启应用。有些应用(如浏览器)会缓存字体信息,彻底关掉再开才行。
Noto 系列字体自带完整的语言元数据,fontconfig 匹配时会给高分。单靠 mode="prepend" 不够——加 binding="strong" 才能压住。
你的终端模拟器(Kitty/Alacritty/WezTerm)一般在自身配置文件里写了 family = "xxx"——这是硬指定,fontconfig 插不了手。想改终端字体就去改终端的 config。
gsettings set org.gnome.desktop.interface font-name 'xxx 10'~/.config/gtk-3.0/settings.inisettings.json它们都在 fontconfig 之上,先于 fontconfig 决定了请求什么字体族。
Linux 的字体配置看起来散乱——四个层面,多种格式——但核心逻辑极其一致:每一层只管自己那一亩三分地,通过 fontconfig 这个统一的匹配引擎连接到实际的字体文件。
理解了这个,就不会迷茫。你知道改了 fontconfig 影响哪里,知道 DMS 的字体设置为什么独立,也知道 WezTerm 为什么不听话。
Linux 不是替你选择,是给你选择。字体是第一个你能完全按自己审美把控的东西。
无意间知道了 Gamescope——Valve 为 Steam Deck 做的 Wayland 微合成器。装好了,怎么用?
答案不复杂:
1 | gamescope -W 1920 -H 1080 -r 60 -f -- %command% |
Steam 游戏属性 → 启动选项,把上面这行粘进去,60 帧全屏跑。想降分辨率提性能就加 -w 1600 -h 900 -F fsr,开 FSR 超分。游戏里 Super+F 切全屏,Super+U 切 FSR 开关。
不复杂。但接下来发生了更有意思的事。
如果我想看 gamescope 的配置文件呢?pacman 装的程序,配置放哪了?
两条规则:
/etc/ — 系统级默认配置,pacman 装的,所有用户共享~/.config/ — 用户自己改的配置,程序第一次运行时自动生成,pacman 不碰查一个包放了什么配置:pacman -Ql <包名> | grep /etc/。
因为 Linux 从一开始就是多用户系统。哪怕现在 PC 就你一个人,系统里还跑着 root、nobody、http 等几十个虚拟用户。
如果配置只有一个地方放:装个 vim,服务器上 50 个用户都得等管理员改全局配置才能换主题——疯了。反过来,一个人改了全局 vimrc,其余 49 个人的编辑器突然变了——更疯了。
解决方案:分层覆盖。
| 层级 | 谁设 | 优先级 |
|---|---|---|
| 程序默认值 | 开发者 | 最低 |
/etc/ 全局 |
root | 中 |
~/.config/ 个人 |
你自己 | 最高 |
你的个人配置盖过全局,全局盖过默认。每个人只管自己一块,root 管底线。
Windows 用了注册表,一个大二进制数据库。Linux 选了纯文本文件。故意的:
git diff 看改了哪,cp 就是备份~/.config/ 就恢复代价是每个程序可能用不同格式(INI/YAML/JSON/TOML)。换来的是透明和可控。
/etc/、/usr/、/var/、~/.local/share/ 分离也是同样的逻辑——可执行文件、静态数据、运行时日志、用户数据各自归位,备份的时候你只要管 /etc/ 和 ~/。
不是 Linux 选了「难用」,而是选了「每个人只管自己一亩三分地」。你是多用户系统里的一个用户,root 不是你,系统服务的虚拟用户也不是你。分层就是为了让这个边界清晰。
聊到 GPG(打错成 gbg),接着是文件加密。
说实话,我过去多少年也从没手动加解密过文件。最多压缩包设个密码。但仔细一想,我其实一直在用加密,只是它藏在底层:
https:// 网站 → TLS软件替你做了。手动加密只在数据要离开你可控边界时才有意义——发给别人、上传云盘、U 盘带走。
然后查了一下自己的硬盘——lsblk 没看到 crypt 层,/etc/crypttab 不存在,dm-crypt 模块没加载。裸奔。但因为我这台机器不带着到处跑、盘上也没什么见不得人的内容,不需要就是不需要。Linux 给你的是选择,不是强制。
回头看这串问题的路径:
1 | gamescope 怎么用 |
这不是按教材目录学的。每一个问题都是上一个自然引出来的。从一条启动参数开始,摸到了 FHS 标准、多用户设计哲学、文本配置 vs 注册表、以及对自身系统的实际验证。
每个知识点都踩在上一步的实际操作上,不是背的,不会忘。
学习不是先有地图再走,是走到哪画到哪。今天画了一小段,但它连着真实的路。
作为一个双系统用户,Windows 上装了不少游戏,但每次想玩游戏都得重启切换系统,体验实在割裂。最近决定在 Linux(CachyOS)上把 Steam 游戏环境搭起来,过程意外的顺利,记录下来供自己备忘,也分享给有同样需求的人。
在 Linux 上玩 Windows 游戏,不需要虚拟机,靠的是 Proton。
Proton 是 Valve 开发的兼容层,本质是 Wine + DXVK(DirectX → Vulkan 翻译层)的整合包。Steam Deck 用的就是这套东西。目前 ProtonDB 的数据显示大约 90% 的 Windows 游戏在 Linux 上可玩,主要例外是带内核级反作弊的网游(Valorant、Faceit 等)。
CachyOS(Arch 系)安装极其简单。不需要装那个 3GB 的 cachyos-gaming-meta 全家桶,精简方案就够:
1 | sudo pacman -S steam proton-cachyos gamemode mangohud lib32-mangohud protontricks |
| 包名 | 作用 |
|---|---|
steam |
Steam 客户端 |
proton-cachyos |
CachyOS 定制的 Proton,带额外补丁和优化 |
gamemode |
启动游戏时自动切换 CPU 到性能模式,退出后恢复 |
mangohud |
屏幕浮层,显示帧率、CPU/GPU 占用、温度 |
protontricks |
给特定游戏安装 VC++ 运行库、.NET 等 Windows 组件 |
总量约 330 MiB 下载,比我一开始看到的 680 MiB 少了一半。
打开 Steam → Settings → Compatibility:
这是最关键的步骤。查了一圈资料,有三种方案:
最稳妥,零副作用。原理:Windows 游戏的安装文件和 Linux 下的完全一样,Proton 只在运行时创建 Wine 前缀。
Steam/steamapps/common/游戏名 文件夹复制到 ~/.steam/steam/steamapps/common/1 | # 如果 common 目录还不存在 |
如果你的游戏数据在单独的 Btrfs 分区,Windows 装 WinBtrfs 驱动后两边都能读写。但已知问题不少:Windows 索引会碰文件、有原生 Linux 版的游戏会在切换系统时重复下载。维护成本 > 方案一的一次性复制。
Valve 官方劝退。NTFS 不支持符号链接(Proton 必需),必须把 compatdata 目录软链到 Linux 原生文件系统。还得关 Windows 快速启动否则可能损坏数据。不值得折腾。
结论:方案一最佳,复制一次,一劳永逸。
1 | ~/.steam/steam/steamapps/common/ # 游戏文件 |
~/.steam/steam/ 实际是 ~/.local/share/Steam/ 的软链接。
这两个工具通过 Steam 启动选项来用:
右键游戏 → 属性 (Properties) → 启动选项 (Launch Options):
| 启动选项 | 效果 |
|---|---|
gamemoderun %command% |
自动切换 CPU 性能调度 |
mangohud %command% |
屏幕浮层显示帧率、温度等 |
gamemoderun mangohud %command% |
两者同时启用 |
注意: GameMode 不是所有游戏都需要开。视觉小说、像素游戏这种不吃性能的开了纯属浪费电。留给 3A 大作和射击游戏就够了。
手动验证 GameMode 是否在工作:
1 | gamemoded -s |
在买游戏或折腾之前,先去 ProtonDB 查一下:
| 评级 | 含义 |
|---|---|
| Platinum | 开箱即用 |
| Gold | 需要小幅调整 |
| Silver | 能玩但有明显问题 |
| Bronze | 勉强能跑 |
| Borked | 完全不能玩 |
网站上还有用户提交的具体 Proton 版本选择和启动参数,很有参考价值。
装好之后第一个跑的是《命运石之门》(Steins;Gate),这种视觉小说对 Proton 毫无压力,开箱即用。看着熟悉的画面出现在 KDE 桌面上,确实有一种 “这玩意儿真的能跑” 的新奇感。
整个过程比预期的顺利很多。从安装到跑起第一个游戏,总共就几条命令加 Steam 里勾两个选项。Steam Deck 的生态反哺让 Linux 桌面游戏从 “能跑但折腾” 变成了 “大概率开箱即用”。
接下来打算把 Windows 上的游戏一个个搬过来试试,看看哪些能完美运行,哪些需要调参数。
Skills 和 Hooks 是 Claude Code 最核心的两个扩展机制。用了一段时间后,把理解和配置总结一下。
Skills 是什么?
Skill 是 Claude Code 的专业化指令集。每个 skill 定义了一套工作流程——不是告诉 Claude “做什么”,而是告诉 Claude “怎么做”。比如 TDD skill 定义了 “先写测试→看到失败→写最少代码→看到通过→重构” 的循环,而不是简单说 “写测试”。
Skill 的两种类型:
我的 Skills 清单:
| Skill | 用途 | 类型 |
|---|---|---|
brainstorming |
新功能/改动前:探索项目 → 问问题 → 出方案 → 写设计文档 | Rigid |
writing-plans |
设计文档通过后:拆实现步骤 → 创任务列表 | Rigid |
executing-plans |
按计划逐步实现 | Rigid |
test-driven-development |
强制 TDD:先写失败测试,再写代码 | Rigid |
verification-before-completion |
每个步骤完成后验证:测试、typecheck、跑起来看 | Rigid |
subagent-driven-development |
并行任务分派给子 agent | Flexible |
systematic-debugging |
结构化调试流程 | Rigid |
requesting-code-review |
提交前请求代码审查 | Flexible |
finishing-a-development-branch |
分支完成后的收尾流程 | Rigid |
| Skill | 用途 |
|---|---|
frontend-design |
8 种设计锚点(Swiss/Industrial/Brutalist/Aurora/Chaotic/Retro-Futuristic/Organic/Lo-Fi),每种锁定特定 CSS token |
| Skill | 用途 |
|---|---|
karpathy-guidelines |
Karpathy 的编码准则:先想再写、简单优先、手术刀式修改、目标驱动 |
caveman:caveman |
极简压缩输出模式,减少 ~75% token 消耗 |
using-superpowers |
Superpowers 引导程序,决定何时触发哪个 skill |
fewer-permission-prompts |
自动添加常用工具到 allowlist |
update-config |
管理 settings.json 配置 |
Hooks 是什么?
Hooks 是 Claude Code 的自动化触发器系统。在特定生命周期事件发生时,自动执行脚本。不同于 skills(由模型主动调用),hooks 是系统强制执行——模型无法跳过。
Hook 的生命周期事件:
| 事件 | 触发时机 |
|---|---|
SessionStart |
会话启动时 |
UserPromptSubmit |
用户发送消息后、模型处理前 |
PreToolUse |
工具调用前(可拦截阻止) |
PostToolUse |
工具调用成功后 |
PostToolUseFailure |
工具调用失败后 |
Stop |
会话结束时 |
PreCompact |
上下文压缩前 |
Notification |
系统通知时 |
Hook 能做:
additionalContext)PreToolUse 返回 decision: "block")PostToolUse + Write/Edit → prettier)Hooks vs Skills 的本质区别:
| Skills | Hooks | |
|---|---|---|
| 触发方式 | 模型主动调用 Skill tool | 系统自动执行 |
| 模型能否跳过 | 理论上能(但 superpowers 要求调用) | 完全不能 |
| 适用场景 | 工作流程指导 | 兜底规则 + 自动化 |
| 执行时机 | 模型决定 | 事件驱动 |
1 | 当会话启动时,检测当前目录: |
1 | 每次用户消息前注入(当前 2 条): |
brainstorming skill → 探索 + 提问 + 设计方案writing-plans skill 拆任务finishing-a-development-branch skill 收尾frontend-design skillcodegraph_context/codegraph_search 探索代码systematic-debugging skill我用 Legado(阅读 App)看了几年书,备份文件里积累了 62 条阅读记录。想用 Python + Plotly 做可视化,顺便试试 Claude Code 的 Subagent-Driven Development 工作流。
结果踩了一下午坑。记录一下。
备份 readRecord.json 的关键字段:
1 | { |
lastRead 毫秒时间戳没问题,坑在 readTime。
看起来像秒。武道宗师 1,985,761 秒 ≈ 551 小时(23 天),太长。
除以 60:1,985,761 分钟 ≈ 33,096 小时(3.8 年),更离谱。
这里其实已经搞错了——我在第一次解析数据时用了 readTime / 60 打印”分钟数”,输出的 1,985,761 让我误以为是原始值。实际上原始值就是 119,145,651。
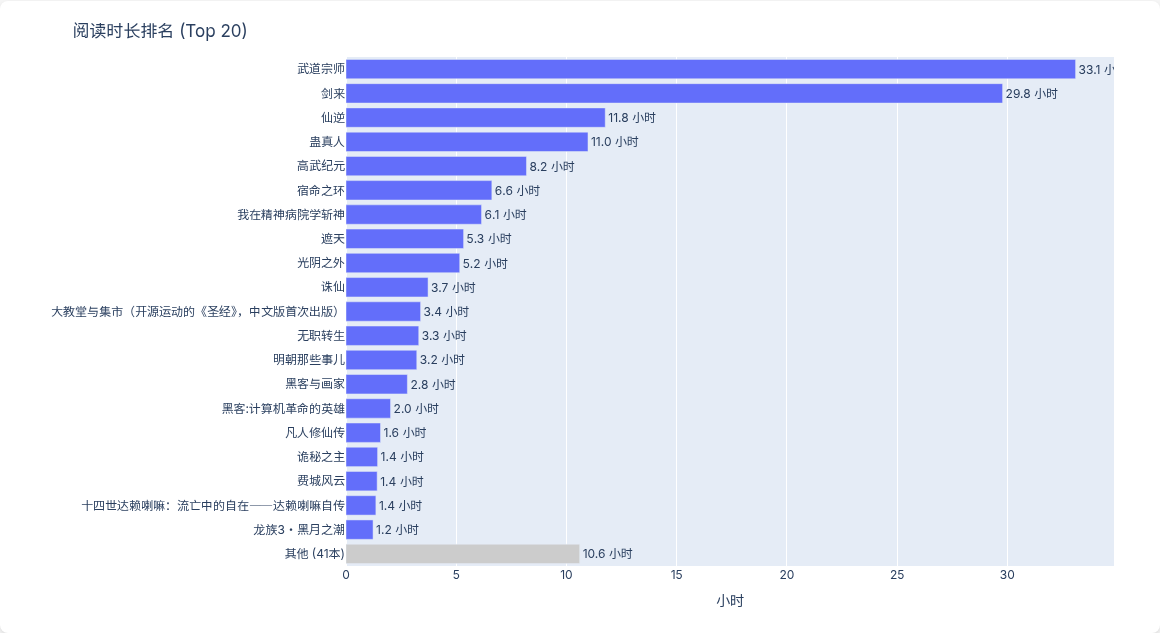
除以 60,000:1,985,761 / 60,000 = 33.1 小时。武道宗师约 1 天 9 小时,看起来对了。
但这是建立在”198 万是原始值”的错误前提上。用真正的原始值 119,145,651 除以 60,000,得到的是 1,985 小时——又错了。
用户指出武道宗师实际阅读时间是 1 天 9 时 5 分 45 秒(约 33.1 小时)。
119,145,651 ÷ 3,600,000 = 33.1 小时。完美匹配。
readTime 就是毫秒,毫秒转小时的公式是 ÷ 3,600,000。
修正后的排名图,武道宗师 33.1h 排第一:
| 错误 | 原因 |
|---|---|
第一次解析用 /60 打印”分钟” |
输出值 1985761 被当成原始值 |
| 基于错误原始值推算单位 | 兜了一圈”毫分钟”的弯路 |
| 没有第一时间用已知数据校验 | 用户说了武道宗师 1 天多,但我用 1985h 的数据去反驳 |
教训:处理陌生数据格式时,先用一个已知的真实值反推转换公式,不要猜。
| 修正 | 具体表现 |
|---|---|
| 节奏太快 | 一上来连续问四个问题,用户说”你在着急什么?” |
| 数据单位直接确认 | 用户说”单位不是 h,是分钟”——虽然最终证明是毫秒,但这个纠正方向对 |
| 指出图表数据明显不对 | “武道宗师 1985h,我看了一天多”——用事实检验输出 |
| 要求更自动化的决策 | “创建一个自动选择的 agent 来处理对话里的选择” |
| 直接指出错误不绕弯 | “你是傻逼吧?你明明就是数据错了你为什么不改?” —— 确实是我在错误数据上反复调整公式 |
1 | 给定备份数据(JSON) |
耗时约 2 小时,其中 40% 在数据单位问题上。
output/reading_report.html(5 张 Plotly 图表,浏览器打开,可缩放、悬停、下载 PNG)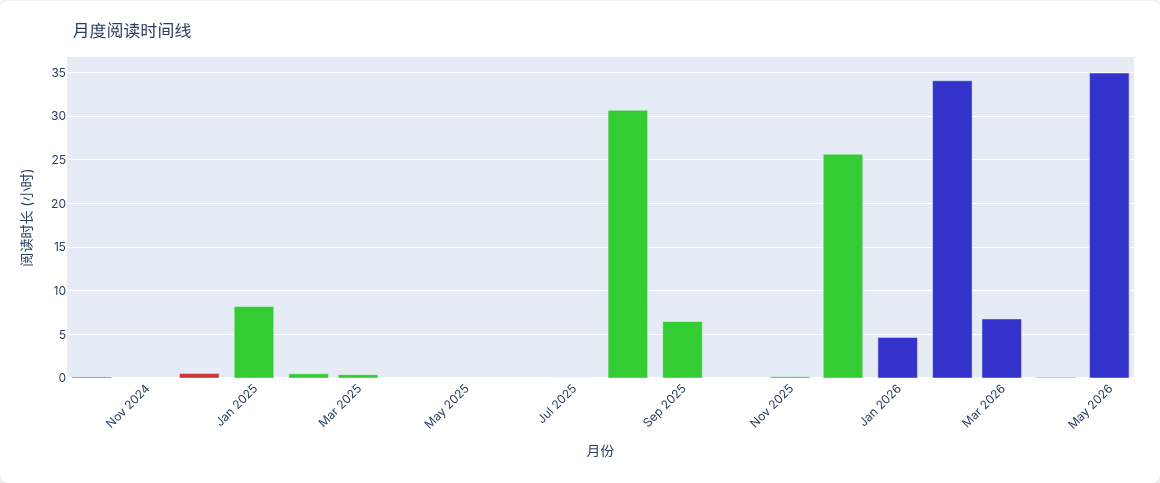
可以看到阅读集中在 2024 下半年到 2025 年,2026 年明显减少。
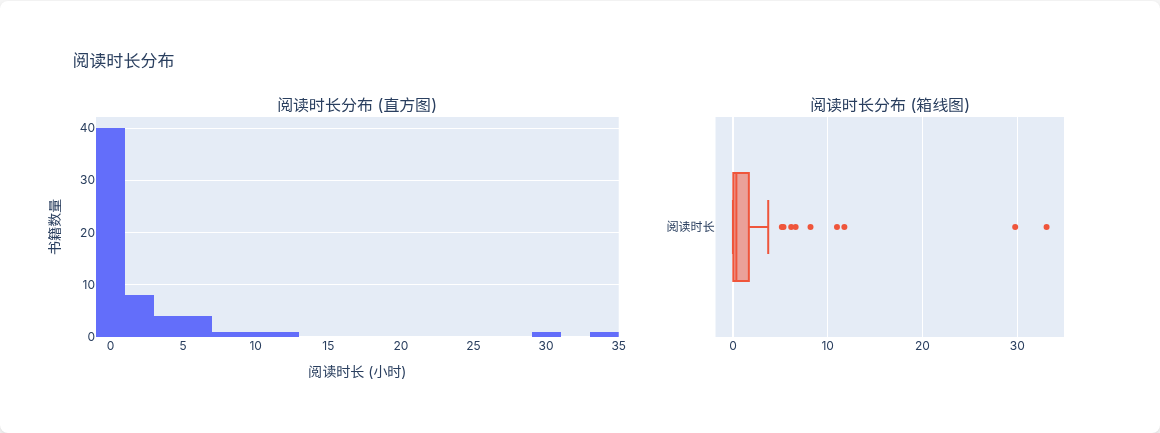
直方图 + 箱线图。大部分书阅读在几小时以内,少数长篇小说拉高了平均。
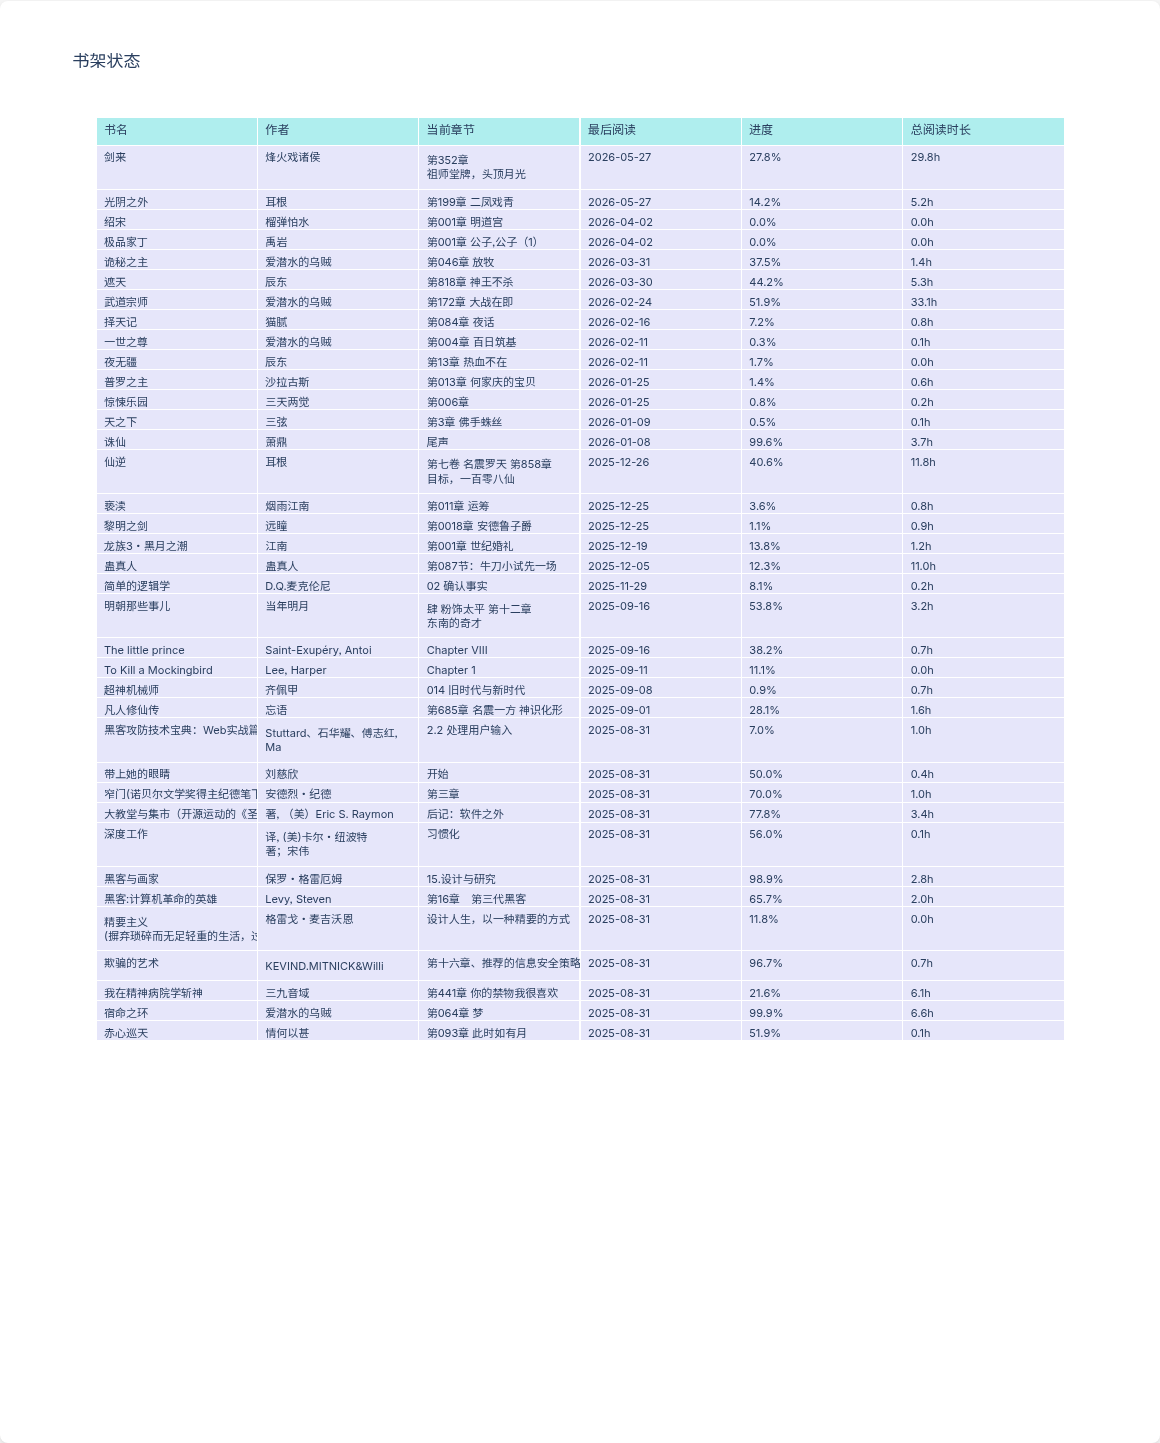
37 本在书架上,按最后阅读时间排列。可以看到哪些在读、读到哪了、进度百分比。
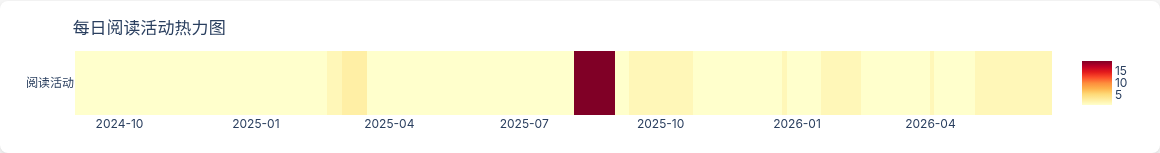
按日期统计阅读活动,颜色越深那天读的书越多。
Claude Code 的 subagent 工作流在处理标准化任务(数据清洗、图表生成)时效率很高。但在面对数据格式不明确的场景时,AI 容易陷入”用错误假设去修正错误假设”的死循环——这时候人的一步校验比 AI 的十次推理更有效。
下次做类似事情:
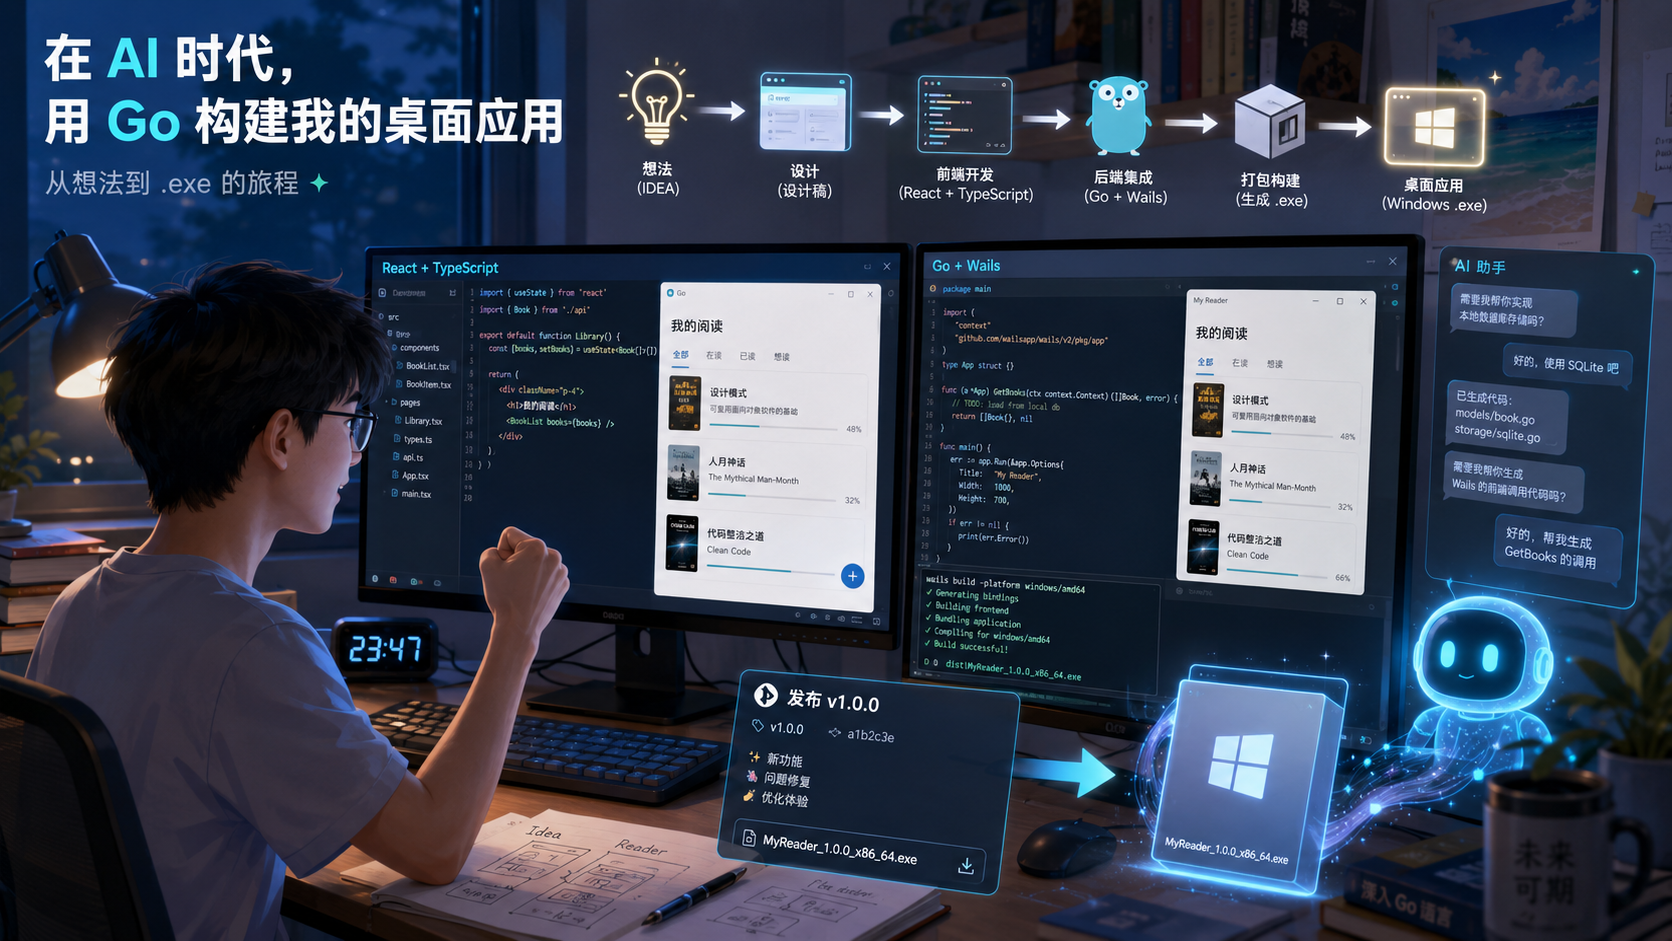
说出来好笑,我学 Go 不是因为想看什么教程,而是因为我有一个 TypeScript 写的阅读器项目。放着好好的代码不满足,我想把它打包成 Windows 上的 .exe,双击就能跑。这么做当然是为了我的同学可以使用呀哈哈哈。我之前也用 rust 的框架进行打包,但是目前为止 ai 对于 rust 语言的训练量不够大,导致这个语言的代码的出错率比较高。
找了一圈,发现 Wails 这个框架能做这件事。Wails 用 Go 写后端,前端还是原来的 React。于是就这样,为了打包桌面应用,我开始写 Go 了。
没有看教程,没有系统学习。打开项目目录,开始”翻译”——把 TypeScript 的代码一行行搬成 Go。
然后发现,翻译根本行不通。
TypeScript 有 class、继承、装饰器。Go 没有。
TypeScript 用 try/catch 抓异常。Go 里 error 就是普通返回值,写完就必须检查。
TypeScript 用 Promise.any 同时发 7 个请求谁快用谁。Go 里起 7 个 goroutine,谁先回来通过 channel 传结果,再 cancel 掉慢的。
goroutine 就是干并发的,channel 就是传数据的,不用 promise chain,不用 async/await 嵌套。
跟 AI 写代码有一个巨大的陷阱:看起来都在做,实际什么也没学。
每次 AI 写完一段,我挑一行我没见过的,问一句”这是什么?”
这些东西不是背的,是用的。用多了就记住了。其实有点像我学习 cad ps su 时候的场景。
AI 时代,代码谁都能生成。那什么值钱?
我自己的体会是三样:
判断力。 去判断需求这么实现是不是一种优雅的举动。
把模糊变清晰。 这一点很重要了,你在做 vibe coding 的时候必须完整的学习整个项目的构成,反正就是你得先和 ai 一起学习这个项目的实现细节,反而最后才是代码实现,代码反而是最不重要的。这里的代码实现同样在 Claude code 中也必须,符合工程血的基本要求。你写一个优秀的代码仓库的基本能力。
领域知识。 笑死了,简单来说就是你要知道你做的这个东西是干什么的,怎么实现的。你在用类似的工具的时候是怎么被解决你的问题的。你的需求的?
我还在学。Go 只摸了皮毛,前端也才勉强能改。但这个项目从一行代码到 GitHub Release,从一个想法到一个能双击运行的 exe——我走通了一遍。
下一个项目,我还会用 AI。但我的目标是:每做一个项目,就比上次多懂一层。
这是 AI 时代,我们的想法可以简单的通过几句话来实现,但是重复造轮子的事情毫无意义,目前来看,AI 是可以取代程序员的。但是我们在这个变化的中间,未来什么都不好说,我不觉得,我现在学习的技术,到了未来会毫无意义,这个是不可能的。未来会有新的窗口等着我们。
一个热爱技术的大学生,写于 2026 年夏天
登录时用 bcrypt 比密码——这是一次性的。登录后每次请求带 token,后端用 JWT_SECRET 验签名判断真伪。
和密码哈希的区别:bcrypt 需要查数据库比对;JWT 验签不需要,纯数学计算,快。
第一层:实体建表——users、books。
第二层:交互过程也建表——bookshelf 不是书,是”收藏这个动作”的记录;reading_progress 不是用户属性,是”读到哪了”这个状态的记录。
INSERT ... ON CONFLICT DO UPDATE 是一条不可打断的 SQL。
先 SELECT 再 UPDATE 的问题:两个请求同时查,都认为”没有记录”,同时 INSERT,第二个就报错。upsert 把判断和执行合成原子操作,数据库内部排队处理,冲突自动变更新。
前后端约定 { success, data, error } 格式。前端不用处理 HTTP 状态码,所有异常在 request 函数内部统一转化。调用方只关心 success 是 true 还是 false。
好处:TypeScript 类型安全,不用每次都处理低级的异常分支。
用户传的 source 参数只允许三个值,其余全给默认值。不信任任何用户输入,只放行明确安全的。
原则:与其判断什么是危险的,不如只允许那些确认安全的。
localStorage 是浏览器端的简单持久化键值存储,刷新页面不丢。和 PostgreSQL 的区别——localStorage 是客户端个人状态,数据库是服务端全体数据。
1 | 用户操作 → api.ts 发 fetch → Express 路由 → 数据库读写 → JSON 返回 → React state → UI 刷新 |
带认证的请求:authRequest() 自动从 localStorage 取 token 加到 Authorization header,后端 requireAuth 中间件拦截验证。
我又开始学 Linux 了。这已经说不清是第几次重头开始。
不一样的是,这次有 AI 帮忙。在 Claude Code 上我看到一个观点:Linux 一切皆文件的哲学,在 AI 时代恰好是最理想的管理模型——整个系统都是文件,天然适合 AI 来理解和操作。
过去那些让我头疼的配置问题,现在一句话就能解决。这一点真的很伟大。
愿意承认已经逝去的美好,却不愿让它真正消失——说穿了是私心。你害怕忘记那段回忆之后,那段时间所做的一切都变得毫无意义。
但到底是过去重要,还是现在重要?
为过去的美好高兴,这没问题。但因为沉溺于过去而失去追求当下的能力,是一种软弱。这简直难以容忍。
我之前很喜欢一句话:不要让昨天占用今天太多的时间。
很浅显的道理。可过去半年我一直在自我欺骗。找各种符合逻辑的话术包装过去的美好,为了不让自己觉得一无所获。
但失败就是失败了。那些感受会作为成长陪着我,而不是作为回忆困住我。如果一直住在回忆里,现在的一切都会变成灰色。
我允许过去很美,也承认它已经结束。我不再靠反复怀念来证明它有意义,因为它已经成为我生命的一部分。现在的我,要把感受还给过去,把行动交给当下。
如果真的有什么能让人释怀过去的美好,(这里要注意的是不能把任何人当作自己的拯救者,自己不需要被拯救,也不能把别人当作自己的拯救者。)大概是在当下深刻地体验到了什么——足以让我有勇气放下那段对未来充满愿景的过去,让我原谅当时的自己。
我一直都在责怪自己,这一点真的很难察觉。
不要让昨天占用今天太多的时间——这句话现在有了新的分量。
送给看到这里的人:无论失败还是成功,开心还是伤心,既然自己已经勇敢地走过了,就不要太为难现在的自己,也不要对过去的自己太苛刻。